🚀 A CloudSEK se torna a primeira empresa de segurança cibernética de origem indiana a receber investimentos da
Leia mais


Informações de identificação pessoal (PII) são quaisquer dados que identifiquem uma pessoa específica, seja por si só ou quando combinados com outras informações disponíveis. Nomes, números de documentos de identidade, endereços e registros biométricos são os exemplos mais óbvios. Essa categoria vai muito além do que a maioria das organizações imagina, e é nessa lacuna que o risco de exposição se esconde.
Um caso recente mostra com que rapidez o abstrato se torna concreto. A pesquisa de cadeia de suprimentos da CloudSEK rastreou uma única pasta .git configurada incorretamente em um fornecedor indiano de serviços automotivos até mais de um milhão de registros de PII expostos. Esse montante incluía mais de 2.000 cartões PAN digitalizados, além de nomes, endereços e números de telefone de clientes.
PII são informações que identificam um indivíduo, seja por si só ou em combinação com outros dados que um invasor já possua. O guia do NIST para proteção de PII define isso com precisão: informações que distinguem ou rastreiam a identidade de um indivíduo, além de qualquer outra informação vinculada ou vinculável a essa pessoa.
Ambos os verbos nessa definição são essenciais. Distinguir alguém significa identificar exatamente quem a pessoa é, como faz um número de passaporte. Rastrear significa reunir detalhes suficientes para estabelecer o que uma pessoa fez ou onde esteve, como faz um registro de acesso.
Vinculado e vinculável traçam uma linha igualmente cuidadosa. Informações vinculadas residem ao lado de outros dados sobre a mesma pessoa em um sistema conectado. Informações vinculáveis aguardam em outro lugar, em registros públicos ou em um banco de dados não relacionado, a apenas um passo de completar o quadro.
Os identificadores dividem-se em dois grupos, e o segundo grupo é o que causa a maioria dos erros de julgamento.
Dentro das PII, alguns dados causam danos graves se expostos, enquanto outros não, e essa distinção determina o rigor com que cada item é protegido. PII sensível identifica uma pessoa diretamente e possibilita fraudes ou discriminação; PII não sensível é frequentemente pública e perigosa principalmente quando combinada.
O contexto altera a classificação dos itens. Um nome completo é não sensível isoladamente, mas o mesmo nome em uma lista de pacientes de um hospital específico torna-se sensível. Programas robustos classificam os dados pelo dano que a exposição causaria no contexto, e não apenas pelo rótulo do campo.
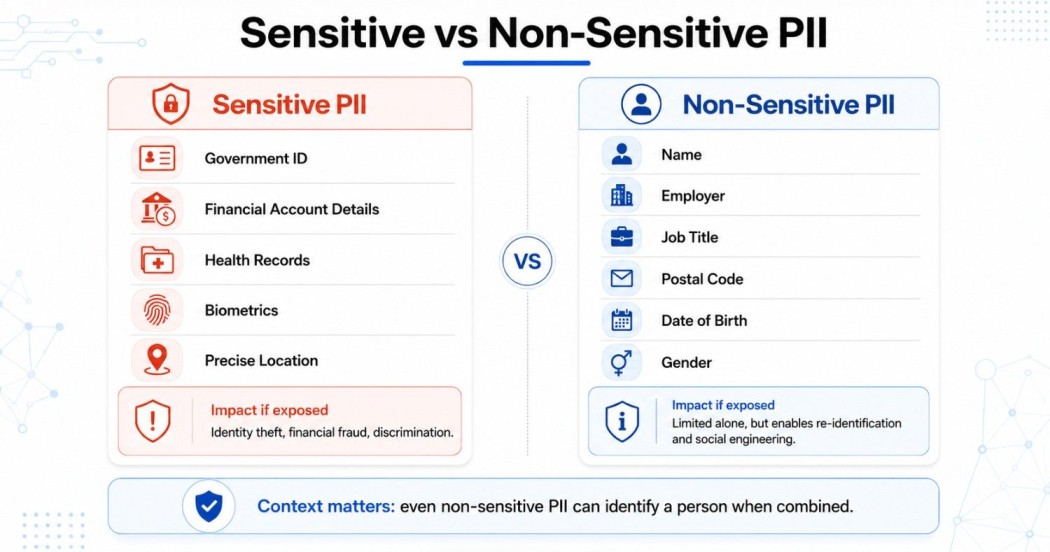
As PII abrangem seis categorias amplas, e reconhecer cada uma delas é o primeiro passo para protegê-las.
Remover nomes de um conjunto de dados parece anonimização. Raramente é.
A análise de Latanya Sweeney sobre os dados do censo dos EUA constatou que 87% da população era identificável de forma única apenas por três campos: CEP de cinco dígitos, gênero e data de nascimento. Em nível municipal, o número manteve-se em 53% e, mesmo em nível de condado, 18% das pessoas permaneciam únicas.
A combinação, e não a sofisticação técnica, é o que realiza o trabalho aqui. Cada atributo isoladamente descreve milhões de pessoas, mas a interseção entre eles frequentemente descreve exatamente uma, e uma lista de eleitores ou de marketing fornece o nome que completa o processo.
Campos idênticos carregam riscos drasticamente diferentes dependendo de quem descrevem. O NIST classifica cada conjunto de PII em um nível de impacto de confidencialidade baixo, moderado ou alto, ponderando o quão precisamente os dados identificam alguém, quantas pessoas abrangem, quão sensível é cada campo e o propósito por trás de sua coleta.
Imagine três listas criadas exatamente com o mesmo esquema: nome, endereço e número de telefone. Uma contém assinantes de newsletter. Outra contém pessoas que solicitam benefícios de aposentadoria. Uma terceira contém policiais trabalhando disfarçados.
As mesmas três colunas, três resultados completamente diferentes em caso de vazamento. O contexto define a proteção que um conjunto de dados precisa, e é por isso que uma lista de verificação campo a campo raramente captura a exposição real.
Três termos que circulam como se fossem intercambiáveis, mas que possuem significados jurídicos distintos.
PII vem das diretrizes federais dos EUA e concentra-se na identificação de um indivíduo específico. Dados pessoais, o termo do GDPR, abrangem um espectro mais amplo: qualquer informação relacionada a uma pessoa natural identificada ou identificável, incluindo identificadores online e registros pseudonimizados onde uma chave separada ainda permite chegar a alguém.
Informações de saúde protegidas (PHI) restringem o escopo novamente. A HIPAA aplica o termo a dados de saúde mantidos por entidades cobertas, como hospitais e seguradoras; portanto, um resultado de exame de sangue idêntico conta como PHI dentro de um sistema hospitalar e como dado pessoal comum dentro de um aplicativo de fitness. A Lei DPDP da Índia adota a expressão dados pessoais, alinhando seu vocabulário ao GDPR em vez da prática dos EUA.
Quatro caminhos são responsáveis pela maior parte da exposição de PII em larga escala, e apenas um deles se parece com uma invasão clássica.
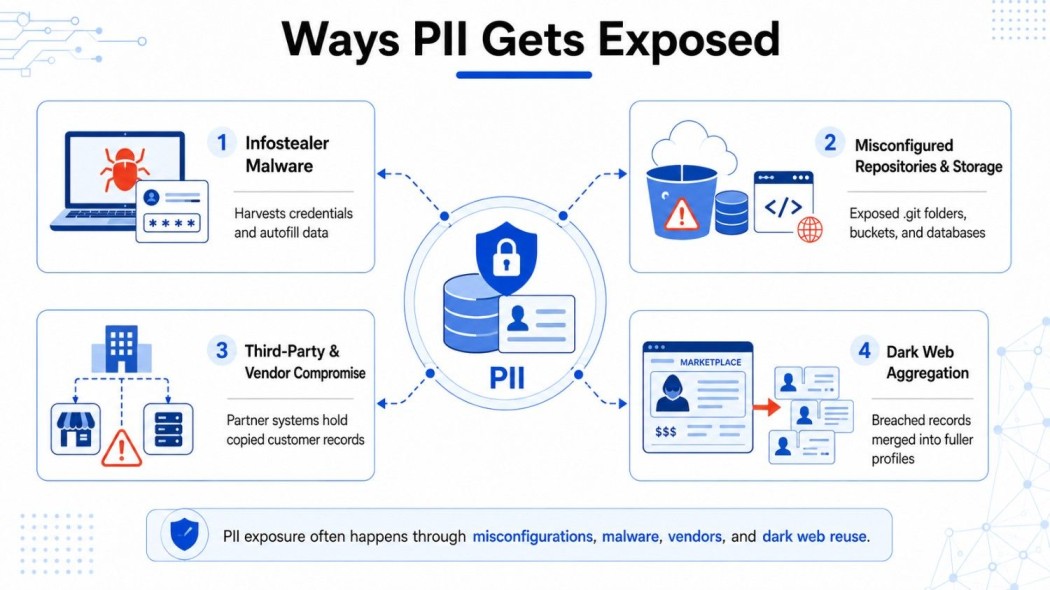
Malwares do tipo infostealer coletam credenciais salvas no navegador, registros de preenchimento automático e tokens de autenticação de uma máquina infectada, empacotando-os em logs vendidos em massa. Um único laptop comprometido entrega os dados pessoais de todos cujos registros aquele funcionário acessou.
Diretórios .git expostos, buckets de armazenamento em nuvem públicos e bancos de dados sem autenticação vazam dados sem qualquer intrusão. O caso do fornecedor automotivo da CloudSEK começou exatamente assim: uma varredura de rotina encontrou uma pasta .git acessível publicamente, e uma ferramenta disponível gratuitamente reconstruiu o código-fonte e os registros de clientes por trás dela.
Fornecedores processam PII de clientes em nome das empresas que os contratam, o que coloca a exposição de uma empresa fora de seu próprio controle. Processadores de pagamento, parceiros de logística, plataformas de marketing e centrais de suporte mantêm cópias de registros que a organização original não governa mais diretamente.
O que acontece após um vazamento é mais importante do que o vazamento em si. Corretores mesclam registros de incidentes separados em perfis consolidados; assim, um número de telefone de uma violação se junta a um endereço de outra e a um número de identificação de uma terceira. Monitoramento contínuo da dark web revela essas listagens enquanto os dados ainda estão sendo negociados, e não depois que são utilizados.
Quem rouba um banco de dados raramente o explora pessoalmente. Os registros são vendidos, mesclados e reutilizados de cinco maneiras recorrentes:
Os preços revelam o quão barato é adquirir esses dados. A investigação da CloudSEK sobre a violação da BWSSB encontrou acesso root ao banco de dados e os registros de mais de 290.000 candidatos, incluindo números de Aadhaar e PAN, anunciados em um fórum de violações por US$ 500, com o vendedor aberto a negociar um valor menor.
As obrigações seguem as pessoas descritas, não a sede da empresa. Quatro estruturas possuem maior peso:
O regime da Índia entrou em vigor em novembro de 2025, quando o Ministério da Eletrônica e Tecnologia da Informação notificou as Regras DPDP nos termos da Lei de Proteção de Dados Pessoais Digitais de 2023. A conformidade ocorre em fases: a estrutura de gestão de consentimento entra em vigor em 13 de novembro de 2026, e as obrigações substantivas que abrangem avisos, salvaguardas de segurança, notificação de violações e direitos dos titulares dos dados seguem em 13 de maio de 2027.
As penalidades conferem peso a esse cronograma, chegando a ₹250 crore por violação. Para organizações que processam dados de pessoas na Índia, 2026 funciona como um ano de preparação, e não como um período de carência.
A proteção funciona como uma sequência, e pular a primeira etapa compromete silenciosamente todas as etapas seguintes.
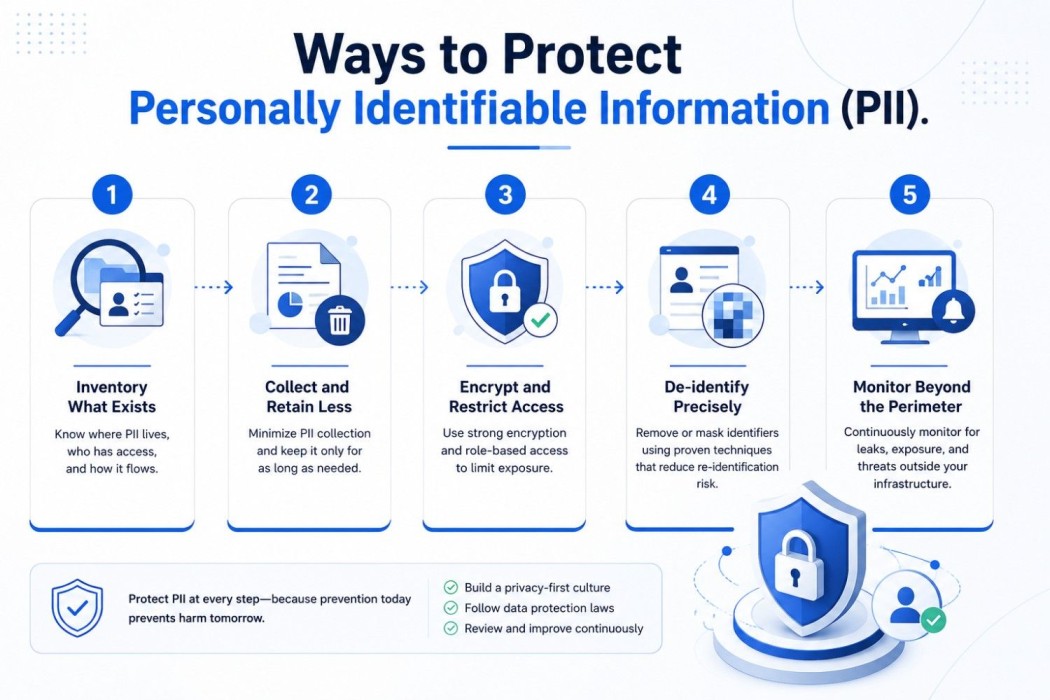
A maioria das organizações descobre um vazamento de PII muito tempo depois de ele ocorrer, geralmente por meio de um cliente, um órgão regulador ou um jornalista. A essa altura, os registros já estão em fóruns ou sites de vazamento, muito além do alcance de firewalls e políticas de acesso.
O XVigil da CloudSEK monitora marketplaces da dark web, fóruns de violação, sites de compartilhamento de texto e canais de mensagens em busca de registros, credenciais e documentos expostos de uma organização, dando às equipes de segurança a chance de reagir enquanto o vazamento ainda tem um raio de impacto limitado. O SVigil lida com o lado dos fornecedores do mesmo problema, verificando a infraestrutura de terceiros em busca de configurações incorretas que expõem dados de clientes na internet pública.
Sim, o GDPR trata um endereço IP como dado pessoal porque ele identifica um dispositivo que pode ser rastreado até uma pessoa. As estruturas dos EUA o classificam como PII apenas quando está vinculado a outros detalhes de identificação.
Sim, o consentimento é uma base legal entre várias. O GDPR permite o processamento sob contrato, obrigação legal ou interesse legítimo, enquanto a Lei DPDP da Índia depende de forma mais restrita do consentimento e de usos legítimos especificados.
Não, o GDPR e a Lei DPDP da Índia aplicam-se apenas a indivíduos vivos. A HIPAA é a exceção notável, protegendo registros de saúde por 50 anos após a morte.
Sim, cookies e identificadores de dispositivo contam como dados pessoais sob o GDPR quando identificam um usuário, mesmo sem um nome associado. O tratamento nas leis estaduais dos EUA varia.
Contenha a exposição revogando o acesso e isolando o sistema afetado. Determinar quais registros foram envolvidos é o próximo passo, antes que os prazos de notificação aos órgãos reguladores e aos indivíduos comecem a correr.
PII identifica indivíduos, enquanto informações comerciais confidenciais abrangem ativos corporativos, como segredos comerciais, preços e contratos. PII vazada aciona leis de privacidade; dados comerciais vazados acionam consequências comerciais.
